P-H3-Imageという画像生成モデルが登場したと聞いたのだ。性能もかなり良いらしいと聞いたのだ。導入手順を教えていただきたい。

ComfyUIでP-H3-Imageを利用する手順を紹介します。
ComfyUIをインストールして、最新バージョンに更新します。
インストール手順はこちらの記事のPortable版のインストールを参照してください。
アップデート手順はこちらの記事を参照してください。
P-H3-Image のモデルをダウンロードします。
以下のHuggingFaceのハブからp-h3-image_int8_convrot.safetensors ファイルをダウンロードします。
VRAMが多いGPUを利用している場合は、p-h3-image_bf16.safetensorsを選択してもよいです。
ダウンロードしたモデルを次のディレクトリに配置します。
(ComfyUIの配置ディレクトリ)\models\diffusion_models\p-h3-image\
以下のHuggingFaceのハブから
p-h3-image_text_encoder_int8_convrot.safetensors
p-h3-image_prompt_upsampler_int8_convrot.safetensors ファイルをダウンロードします。
VRAMが多いGPUを利用している場合は、
p-h3-image_text_encoder_bf16.safetensors
p-h3-image_prompt_upsampler_bf16.safetensorsを選択してもよいです。
ダウンロードしたモデルを次のディレクトリに配置します。
(ComfyUIの配置ディレクトリ)\models\text_encoders\p-h3-image\
以下のHuggingFaceのハブからp-h3-image_vae_int8_convrot.safetensors ファイルをダウンロードします。
VRAMが多いGPUを利用している場合は、p-h3-image_vae_bf16.safetensors を選択してもよいです。
ダウンロードしたモデルを次のディレクトリに配置します。
(ComfyUIの配置ディレクトリ)\models\vae\p-h3-image\
MiniMax-H3のモデルを利用して、P-H3-Imageを利用する場合にはLoRAを利用します。
MiniMax-H3のFL2VAにLoRAを適用すると、P-H3-Imageとして動きます。
LoRAを利用する場合は、
以下のHuggingFaceのハブからp-h3-image_lora_bf16.safetensors ファイルをダウンロードします。
ダウンロードしたモデルを次のディレクトリに配置します。
(ComfyUIの配置ディレクトリ)\models\vae\p-h3-image\
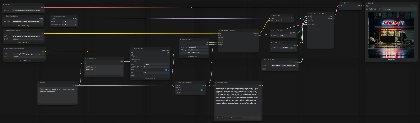
ワークフローは、https://huggingface.co/PrunaAI/P-H3-Image-Comfy/tree/main/workflows からダウンロードできます。
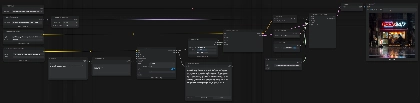
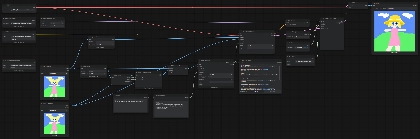
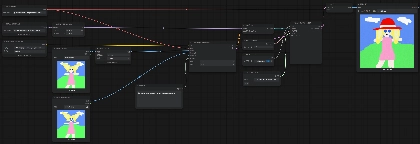
以下のワークフローを利用します。上から、スイッチで upsampler のON/OFF を切り替えられるワークフロー、
upsampler を利用するワークフロー、upsampler を利用しないワークフローになっています。
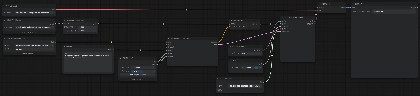
以下のワークフローを利用します。ワークフローの種類は先と同様、スイッチ切り替え、upsamplerあり、upsamplerなしとなっています。
以下のワークフローを利用します。ワークフローの種類は先と同様、スイッチ切り替え、upsamplerあり、upsamplerなしとなっています。
[拡散モデルを読み込む]ノードで読み込むモデルが、P-H3-Imageのモデルではなく、MiniMax-H3の FL2VAのモデルを読み込みます。
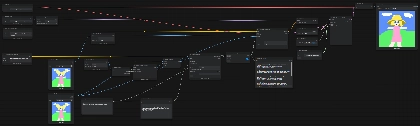
以下のワークフローを利用します。ワークフローの種類は先と同様、スイッチ切り替え、upsamplerあり、upsamplerなしとなっています。
[拡散モデルを読み込む]ノードで読み込むモデルが、P-H3-Imageのモデルではなく、MiniMax-H3の FL2VAのモデルを読み込みます。
ComfyUIの[実行する]母田をクリックすると、画像生成が実行されます。
P-H3-Image の画像生成結果はこちらの記事を参照してください。